Contents
本来只是想让网页在深色模式下看着舒服一点,后来折腾成了一轮 System 1 实验。
我做的浏览器插件叫 Semantic Dark。最开始的想法挺直接:普通文字和背景按规则处理,遇到图片、图表、logo 这些需要看内容判断的东西,让一个本地小模型来选怎么改。不让模型直接写 CSS,就给它几个能执行的有限动作,让它挑一个。
说白了,就是想在写死的规则和找一个 coding agent 慢慢修页面之间,加一个便宜、反应快的中间层。我把它叫 System 1。它不用追平大模型,只要效果过得去,延迟和成本低到我愿意一直开着就行。
这个方向我到现在还是觉得值得试。但折腾下来最花时间的,其实是搞清楚到底哪些问题真该交给它。
现成的方案和 Chromium 的尝试
深色模式插件当然不缺。这里先把几个相关方案摆出来,后面才好说我们到底想补什么。
| 方案 | 这次主要参考什么 |
|---|---|
| Dark Reader | 开源扩展。它的 Dynamic 模式会分析样式表、背景图和 SVG,另外还有 Filter、Filter+、Static 等模式。我们实际拿它的动态引擎做过对照,关心的是样式怎么接管和更新,不只是颜色公式。官方说明 |
| Noir | Safari 扩展,也有 macOS 版。官方介绍是加载时分析页面、逐页生成深色主题,支持站点设置;把网页误判为自带暗色时,也有手动覆盖选项。这里列的是产品说明和 FAQ,不把它当作同条件实测结果,也不去猜内部用了什么算法。 |
| Chromium Auto Dark Mode | 浏览器内部的自动深色化尝试。2021 年的试验说明已经写到:调整颜色明度,先按图片大小和特征分类,再用机器学习帮助区分图标和照片。这里的 ML 做的是图片分类,和我们尝试的局部动作选择任务有区别。 |
之前查 Chromium 那段记录时,我关心的是它为什么没有把 Auto Dark Mode 做成常规浏览器功能。这里说的“没做成”要限定范围:给原本浅色的网页自动生成深色外观。浏览器界面的暗色主题、网站自己写的 dark mode,是另外两件事。
在 2021 年的试验讨论里,Peter Beverloo 把 Auto Dark Mode 称为 fairly intrusive。团队收到的开发者反馈是 mixed:有人喜欢它能减少维护第二套主题的成本,也有人担心自动变色的质量,所以当时把逐元素 opt-out 一起纳入试验。
2025 年 3 月的这条提交把现状交代得更直接,说明里写着:“A project to add this as a browser feature was not successful.” 但提交标题恰好是 Extend enable-force-dark indefinitely:保留实验 flag,并说明相关能力作为 WebView API 仍在使用。这次更新文章时,对应的Chrome Status 试验条目标的是 No active development。
按公开记录能确认的是,那次浏览器产品化尝试没成,实验 flag 和 WebView 的使用路径仍被保留。当年的质量顾虑,也没有被官方写成唯一的失败原因。Dark Reader 和 Noir 则都留了按站点设置、覆盖错误判断和报告兼容问题的入口。回到自己的插件,我想问的还是:加一个小模型,究竟能补上哪一类现成方案还处理不好的情况。
早期的动作选择实验
早期实验里,我们给模型看原图和几个实际渲染出来的候选:保留当前结果、调暗、单色化、反色。这么做主要是为了把“模型选错了”和“模型选对了但代码没画对”拆开。
当时拿 0.8B 模型跑过一次 LoRA(CE + Brier,seed 17)。测试集很小,是 9 个独立的测试组件,每个组件按两种候选顺序各跑一次,一共 18 次呈现(注意不是 18 个独立网站)。在训练端的 BF16 评估里,严格可接受的选择从 base 的 9/18 提到了 15/18。数字看着涨了不少,但同时多了 1 次新损坏:一张本来正常的照片被反成了负片。同一张图换个候选顺序,模型选出来的结果还会变。
另外,实验里用来兜底的简化 writer baseline 比插件当时的实际生产版本要弱。模型比这个简化 baseline 多选对几次,放到真实插件里未必就真多修好了几个页面。何况把一张图表的字救清楚一点,和把一张正常照片搞成负片,在日常体验里根本没法互相抵消。
还有一个更实在的问题:有时候候选列表里压根没有正确答案。之前遇到一个开关控件,整块反色能救活一半内容,但会把旁边的字毁掉;直到后来往动作空间里补了针对控件状态的处理,才算有了能选的对答案。如果给出去的动作本身就糙,模型在几个坏选项里挑得再准也没用。
静态截图之外的动态闪白
前面的实验基本都在页面加载完之后截张图看结果。但实际用起来,更烦的是另一件事:点个按钮、展开一块内容,或者跳去下一页的时候,页面会先白一下再变暗。只看最后的静态截图,这个问题完全是隐形的。
后来专门搭了动态测试去抓,发现“白一下”来自好几个不同的地方:有的是新插入的 DOM 还没轮到处理;有的是 CSS-in-JS 改了一条规则,触发了整页恢复原色再重算;还有的是多页应用(MPA)跳转后,新文档第一帧已经画出来了,主题判断还没跑完。在一个带主题标记的 CSS-in-JS fixture 上,浅色画面能停接近一秒,复现和测量都留在了 #4 里。
这种时序问题,颜色函数写得再好也没用,更别提把动辄几百毫秒的本地 VLM 挡在每次点击的绘制前面了。我们也拿 Dark Reader 的动态引擎做过对照,把同一套变色函数塞进不同的执行路径里跑。至少在当时测的那几组交互上,颜色怎么算和页面闪不闪白,可以拆开处理。
最后这块拆成了三个补丁来修:#4 处理页面内的重扫和交互,#5 修 HN 长页面在 quirks mode 下采样点跑到视口外的问题,#6 在 MPA 新文档首帧之前先垫一层暗色底。
有意思的是,这三个 PR 各自的测试都过了,合到一起却在 man7 上搞出了新回归:#6 的预绘制层会先把背景设成透明,而 #4 把读取颜色的时机提前了,刚好读到了我们自己塞进去的透明背景,结果 man7 的正文背景没被映射,预绘制层一撤就露出一大片白底。最后又给原始样式补了专门的读取窗口才修好。至于新闻 feed 滚动加载这类场景,当时的复测里还有残留,远没到所有动态网页都不闪的程度。
移植 WebKit 的颜色函数
11 月 3 日,WebKit 发了博客 Introducing Adaptive Dark Mode,里面讲了 Safari 27.3 beta 的自适应深色模式。我看到这篇的时候,第一反应是:这不就是我们在折腾的事吗?同样是先区分内容,再决定哪些颜色要变、哪些要留。
我让 coding agent 去 WebKit 仓库里扒实现。一开始搜 Adaptive Dark Mode 没搜到,顺着发布前的 commit 往前追,才发现内部名字叫 AXCustomColorMode。从公开提交(比如这条图片处理提交)能看到页面外观检测、文字背景分析、图片绘制时变色,以及防止 canvas 暴露状态的接线;但核心控制器和图片分类器是从私有的 WebKitAdditions 引进来的,我们查到的公开仓库里没有完整策略。
不过顺着这轮排查,我们把 WebKit 早就公开的 legacy 函数 apple-invert-lightness() 移植了过来。它的做法是先做 HSL 色相旋转,再乘一个固定颜色矩阵。代码里的矩阵系数是写死的常量,并没有在网页上跑模型;至于系数最初怎么推出来的,源码注释只指向了 Apple 内部记录。
这里得把三样东西分清楚:我们早先试过的 Apple PDFKit 变色矩阵、这次移植的公开 legacy 函数 apple-invert-lightness(),以及 Safari 27.3 新版 Adaptive Dark Mode 的私有策略,是三个不同的东西。之前 PDFKit 矩阵在网页实验里效果一般,不能直接拿来否定 WebKit 这个公开函数;反过来,我们现在做的也不是复刻新版 Safari 的完整方案。
换上 apple-invert-lightness() 之后,我自己肉眼看确实比原来舒服。回头看插件的代码,才发现问题就摆在那里:原来算法把 surface 的明度压在了一个很窄的区间里,原本有层次的几层浅灰背景,变暗之后全糊成了一团。
同样按 surface 处理,三个灰阶在两套方案下的结果差得很明显:
| 原色 | 原来的映射 | WebKit 公开函数 |
|---|---|---|
#ffffff |
#1f1f1f |
#333333 |
#dddddd |
#232323 |
#4e4e4e |
#cccccc |
#252525 |
#5c5c5c |
看这个表就明白为什么以前很多卡片和分区分不出来了。新映射拉开了背景层次,虽然不敢说对所有网站都更好,但之前看着发闷的原因算是找到了。
当然,换完公式还得擦屁股。旧逻辑默认所有背景都会被压得很暗,所以有些地方觉得“只要字是亮的就能看清”;换成矩阵后,局部子区域有可能变亮,继承下来的白字反而会糊,渐变背景光查最亮的一端也不够了。后面又紧接着补了一轮对比度修正。
8 个诊断样本与 SIMONS logo
执行器换完,我重新跑了一组候选图,想看看模型在新的底座上还能帮上什么忙。这次用的 8 个素材全是之前已经暴露过的公开样本(包含照片、图表和 logo),只是拿来诊断问题,不算 held-out 测试集;可接受动作的标签也是 AI 在模型推理前看图定的,不是人类标注的 gold label。
里面最典型的是下面这个 SIMONS logo:深蓝色字叠在深色背景上,基本看不清。五个候选里,保留原图(A)和继续调暗(B)都不够清楚,直接加一块白底(E)就能救活,还能保留原本的品牌蓝。
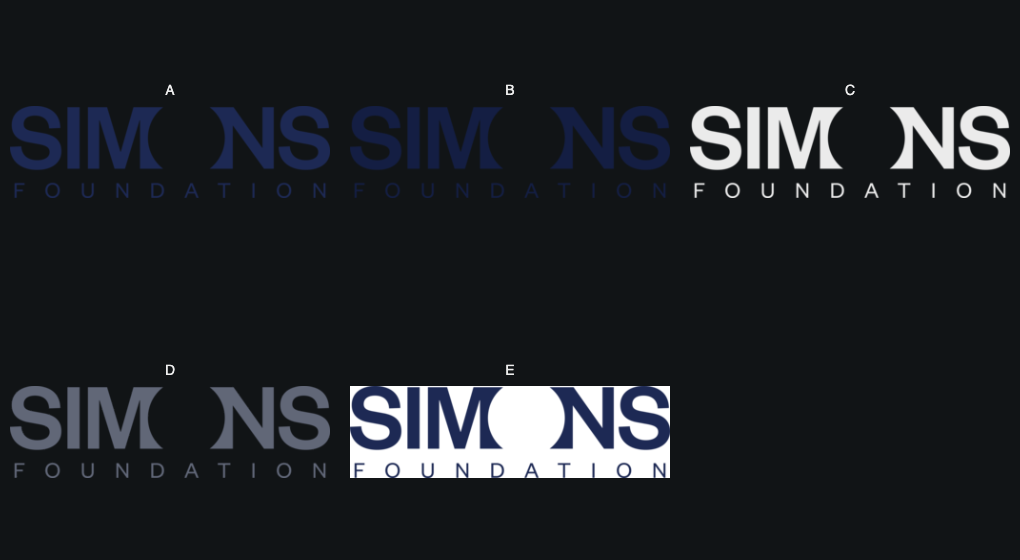

在这张尺寸较大的五候选拼图上,本机已有的 0.8B Q8 模型确实选对了加白底。按推理前冻结的标签算,8 个诊断样本里旧 baseline 是 7/8,固定模型的选择是 8/8,唯一多选对的修复就是这个 logo。
这还只是离线选候选的成绩。当时插件甚至没允许这个彩色 logo 选“加白底”,先修了这个判断,才继续接真实接口。
真正接到浏览器扩展的接口时,输入改成了 128px,候选缩减成三个,背景和指令也变了。模型又选了“保留”。哪怕把实测对比度数字直接塞进 prompt,它还是选错。因为这一下同时改了分辨率、候选集、背景和指令格式,没法断定是哪一个因素导致这次错误;前面大图上的成功,没有直接迁移到实际接口上。
再看这个 case,有一部分判断其实可以直接算:“透明背景 logo 上的不透明笔画跟当前底色对比度不够,垫一层白底后对比度达标”,这是一个数值条件。
于是我直接在规则里补了这条对比度约束(遇到复杂合成背景先跳过,只处理能算准的情况)。接着在源图和候选 PNG 字节完全一致、不重新改标签的前提下做了一次配对重算:补完约束的新 baseline 也到了 8/8,模型在这 8 个样本上的新增修复变成了 0。
也就是说,这个 logo 最后是被确定性规则修好的,不能算在模型头上。这当然不等于证明小模型彻底没用,但至少在这组样本上,这个原本可能体现模型价值的例子,已经被 baseline 修好了。
本地接入与现状
本轮的接入和测量是在 0.4.1 上完成的,前面提到的 PR(#4 到 #8)都已经合入主干。随后又补了背景变化时重算 logo 等边界问题,当前版本到了 0.4.2。
现在插件的执行链是拆开的:先收集观察,再在有限动作里做选择,最后交给执行器改颜色。默认开启的走的是确定性规则 + WebKit 颜色矩阵 + logo 对比度修复;本地模型做成了默认关闭的 opt-in 实验选项,而且只接了“透明彩色 logo”这一条窄路径,其他图片还是走原路由。这个选项还依赖本机的模型环境;因为没验证出明确的增量收益,也没有默认打开。代码和实验记录都在仓库里。
从弹窗开关、service worker、本机推理服务,到 DOM 更新和关闭后恢复,这条通路都用真实实现跑了一遍。超时、过期或切图之后的结果,也有对应的丢弃逻辑和测试。
在一次命中模型缓存的控制图测试里,从点击弹窗开关到页面生效大概是 86 ms;但那张控制图本身就是清晰的,动作只是“保留”,而且走了缓存。在它之前跑的一个新输入请求,走 prepared API 用了 632 ms,超过了设置的等待预算,扩展按约定做了超时回退。这两个数字的计时边界不同,既不能拿来除出一个加速比,也不能拿 86 ms 去吹“新输入都能在 500 ms 内修好”。
这一轮我没有接着训新权重。先把 baseline 能用规则和公式修好的部分补齐,再去捞那些规则依然搞不定的真实样本,才清楚下一批训练数据该怎么配。而且里面要同时有“该修”和“本来就正常、千万别乱动”的样本,不然很容易训出一个到处乱改图片的模型。
回头看,我最开始想让 System 1 管的事太多了。首帧和交互闪白属于渲染时序,颜色映射可以借鉴公开实现,这个 logo 的笔画对比度也能直接计算。先把这些地方做好,再拿剩下的失败样例去比较 baseline 和小模型,才知道它还值得负责哪些判断。
代码和实验执行大部分交给 coding agent,我负责提问题、看结果,以及在它觉得“测试过了就可以结束”的时候让它继续往下查。